作者|晨星行銷 陳俊鳴執行長(網路流量操盤手・企業行銷顧問)
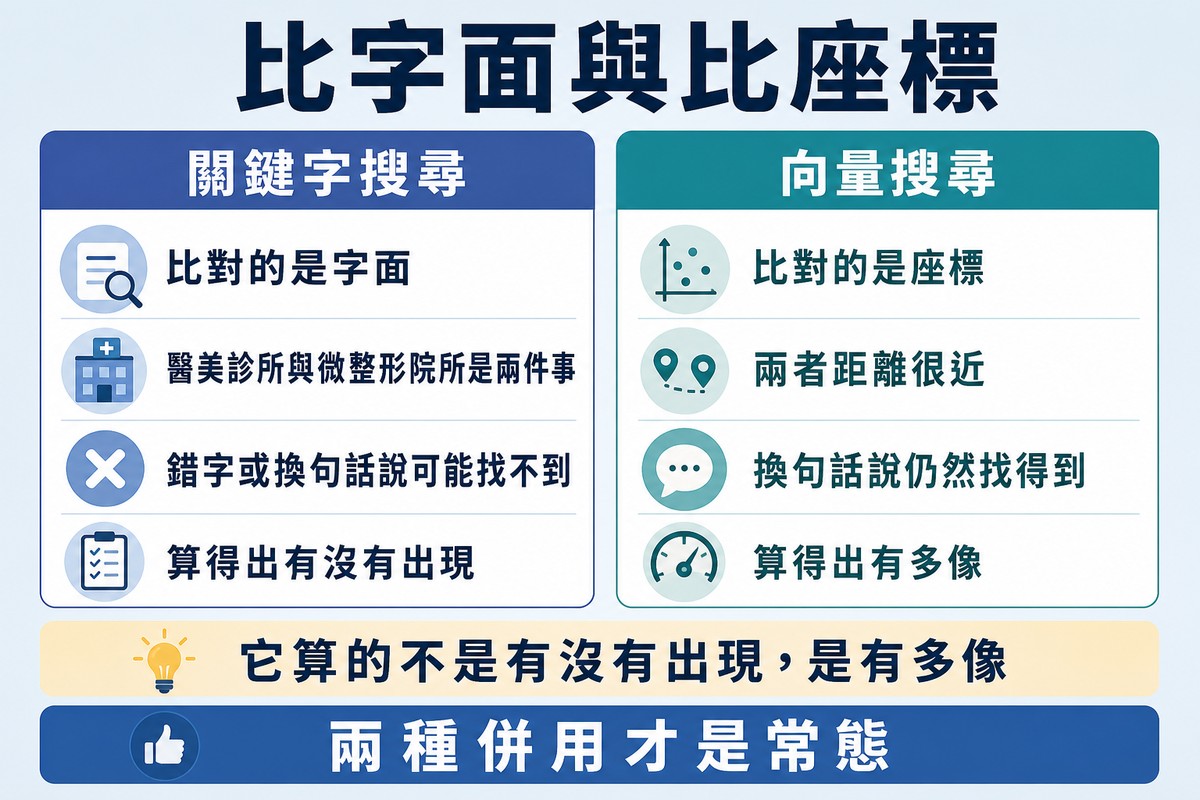
傳統搜尋在做的事很單純:比對字串。你打「醫美診所」,它找含有這四個字的頁面。
向量搜尋做的是另一件事:把文字變成一組座標,然後去找座標附近的鄰居。
| 關鍵字搜尋 | 向量搜尋 | |
|---|---|---|
| 比對的對象 | 字面 | 座標 |
| 「醫美診所」與「微整形院所」 | 兩件事 | 距離很近 |
| 錯字或換句話說 | 可能找不到 | 仍然可能找得到 |
| 它算得出來的 | 有沒有出現 | 有多像 |
這篇只講機制——策略上關鍵字還要不要塞、要怎麼佈局,那是另一篇的題目。至於 SEO、AEO 與 GEO 這三個名詞的差別,站上也另有一篇。
第一件事:嵌入(embedding)
Google Cloud 的官方文件對這個詞的定義只有一句話:
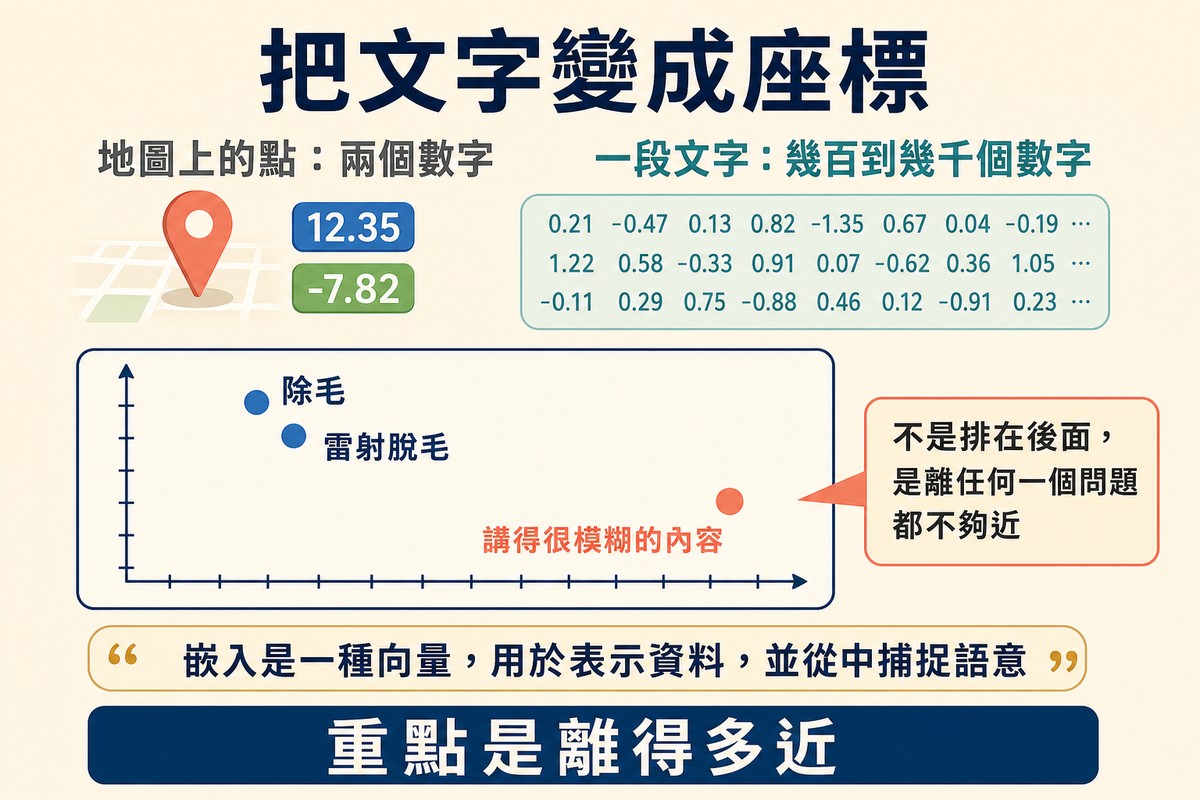
「嵌入是一種向量,用於表示資料,並從中捕捉語意。通常會使用機器學習技術建立嵌入。」
那什麼是向量?官方也給了定義:「向量是浮點值清單,具有大小和方向。可用於表示任何類型的資料。」
💡 小提醒
把它想成座標就好。
地圖上的一個點用兩個數字(經度、緯度)表示;一段文字則用幾百到幾千個數字表示。⚠️ 數字本身沒有意義,有意義的是「兩段文字的座標離得多近」。
這就是官方講的那句話:透過密集嵌入,「系統可以根據語意相似度傳回類似的搜尋結果」。
這件事對內容的影響是:你用哪個詞,不再是唯一決定因素。「除毛」跟「雷射脫毛」在座標上會很近,所以用哪一個寫,不會像關鍵字時代那樣造成天差地別。
⚠️ 但反過來也成立:如果你的內容講得很模糊,它的座標就會落在一個誰都不像的地方——不是被排在後面,是離任何一個問題都不夠近。
第二件事:分塊(chunking)
這是最少人講、但對內容影響最大的一步——而且它不在你的控制範圍內。
Google Cloud 在 RAG 流程的說明裡,把它寫在「資料轉換」那一階段:
「轉換資料以準備建立索引。舉例來說,資料會分割成多個區塊。」
為什麼要切? 因為一整篇三千字的文章,如果整篇算成一個座標,那個座標會是全文的平均——而平均值通常誰都不像。
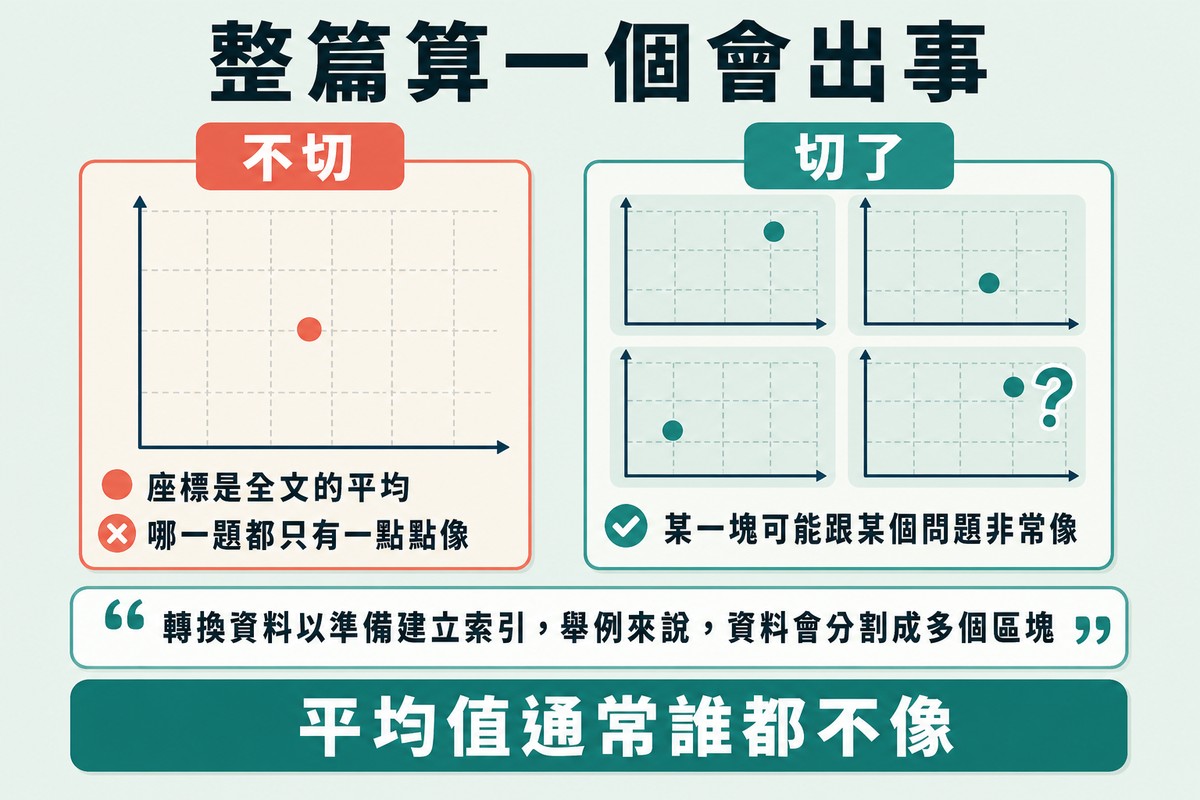
| 不切 | 切了 |
|---|---|
| 一篇文章一個座標 | 一篇文章好幾個座標 |
| 座標是全文的平均 | 每一塊各自代表自己在講的東西 |
| 哪一題都只有一點點像 | 某一塊可能跟某個問題非常像 |
⚠️ 注意
分塊這件事,直接決定了「你的哪一段會被找出來」。
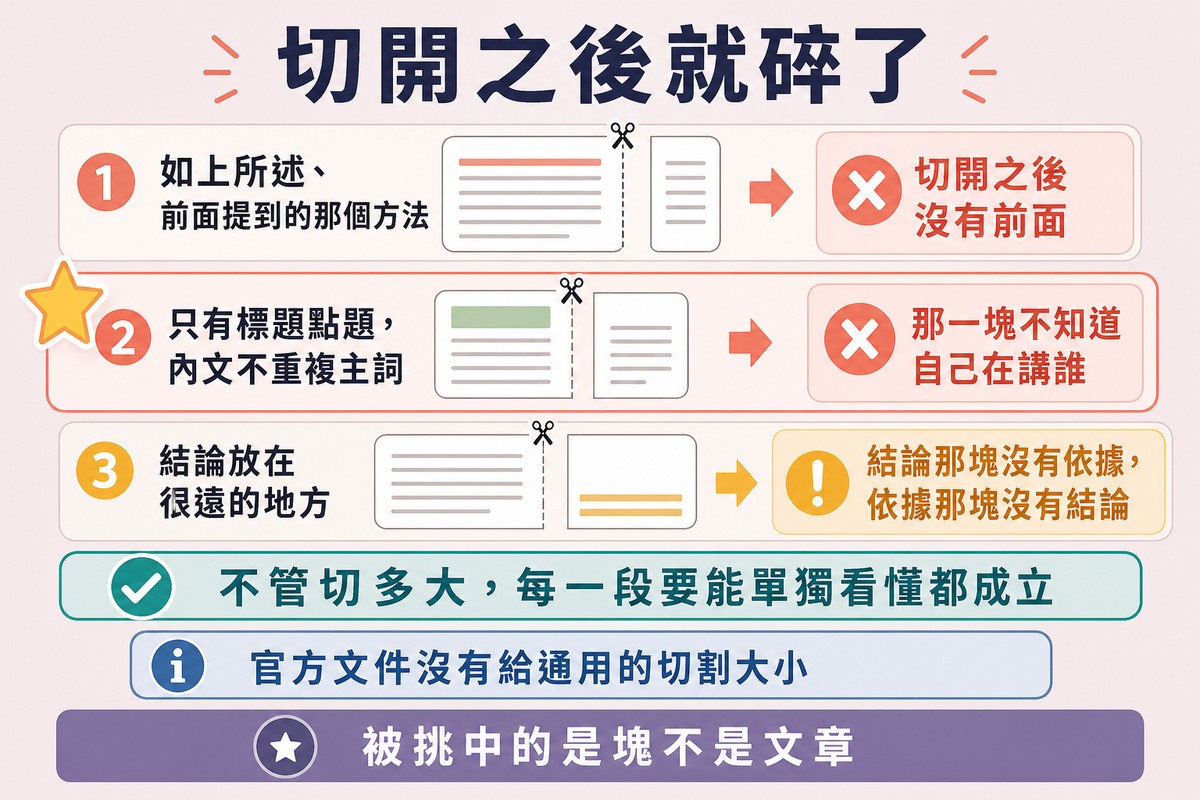
被檢索到的不是「你的文章」,是「你文章裡的某一塊」。⚠️ 所以一段內容如果需要前後文才看得懂,它被單獨切出來之後,可能就不成立了。
實際會出事的寫法: – 「如上所述」「前面提到的那個方法」——切開之後沒有前面 – 一個只有標題點題、內文卻不重複主詞的段落——那一塊不知道自己在講誰 – 把結論放在很遠的地方——結論那一塊沒有依據,依據那一塊沒有結論
⚠️ 官方文件沒有給通用的切割大小,所以本篇不提供任何「要切幾個字」的數字——但「每一段要能單獨看懂」這個原則,不管切多大都成立。
第三件事:找鄰居(最近鄰搜尋)
有了座標,剩下的問題只剩一個:離這個問題最近的幾塊內容是哪些。
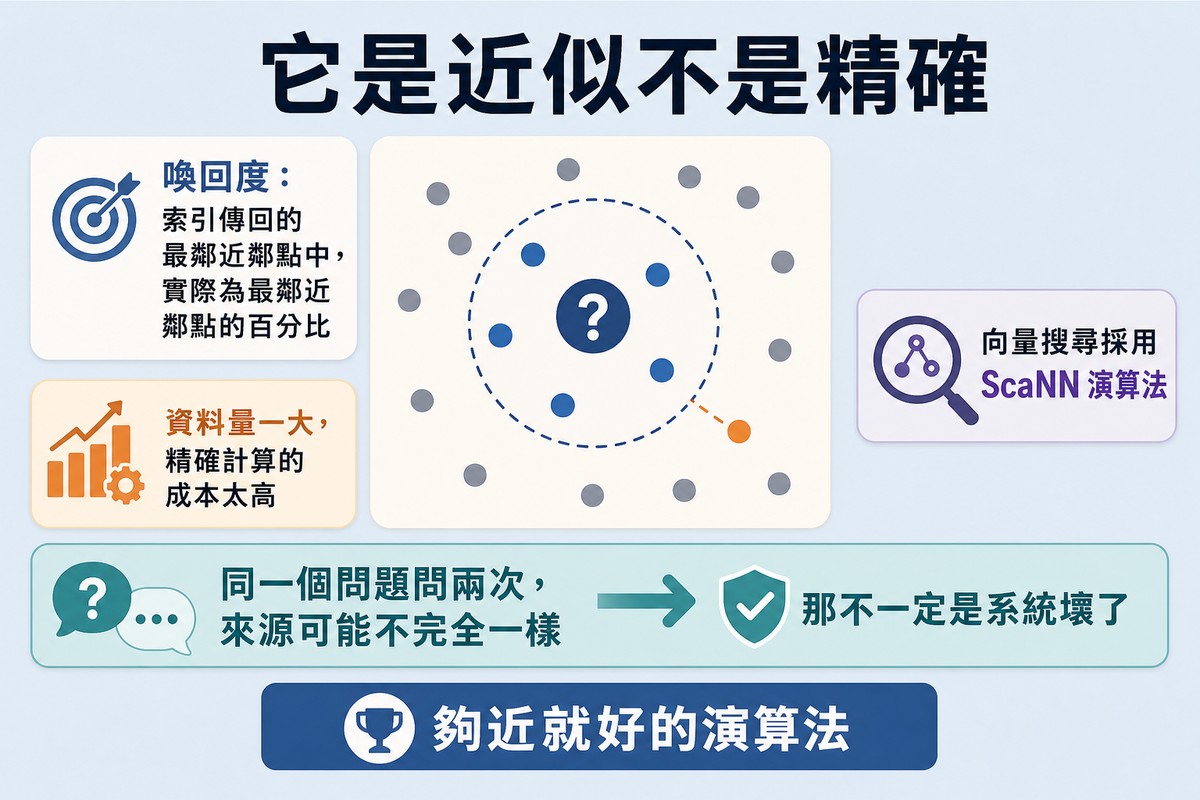
官方用的評估指標叫喚回度,定義是:「索引傳回的最鄰近鄰點中,實際為最鄰近鄰點的百分比。」
💡 小提醒
這個定義透露了一件很重要的事:它是近似的,不是精確的。
⚠️ 為什麼要近似?因為資料量一大,要精確算出「所有內容裡誰離得最近」的成本太高。所以實務上用的是「夠近就好」的演算法——Google 的官方文件寫明「向量搜尋採用 ScaNN 演算法」。
這也解釋了一個常見的困惑:同一個問題問兩次、或在不同時間問,拿到的來源可能不完全一樣。那不一定是系統壞了,近似本來就會有浮動。
把 RAG 流程串起來:系統挑的是區塊,不是文章
Google Cloud 的 RAG 流程說明,把整條鏈拆成六段。用你的內容當主角,它長這樣:
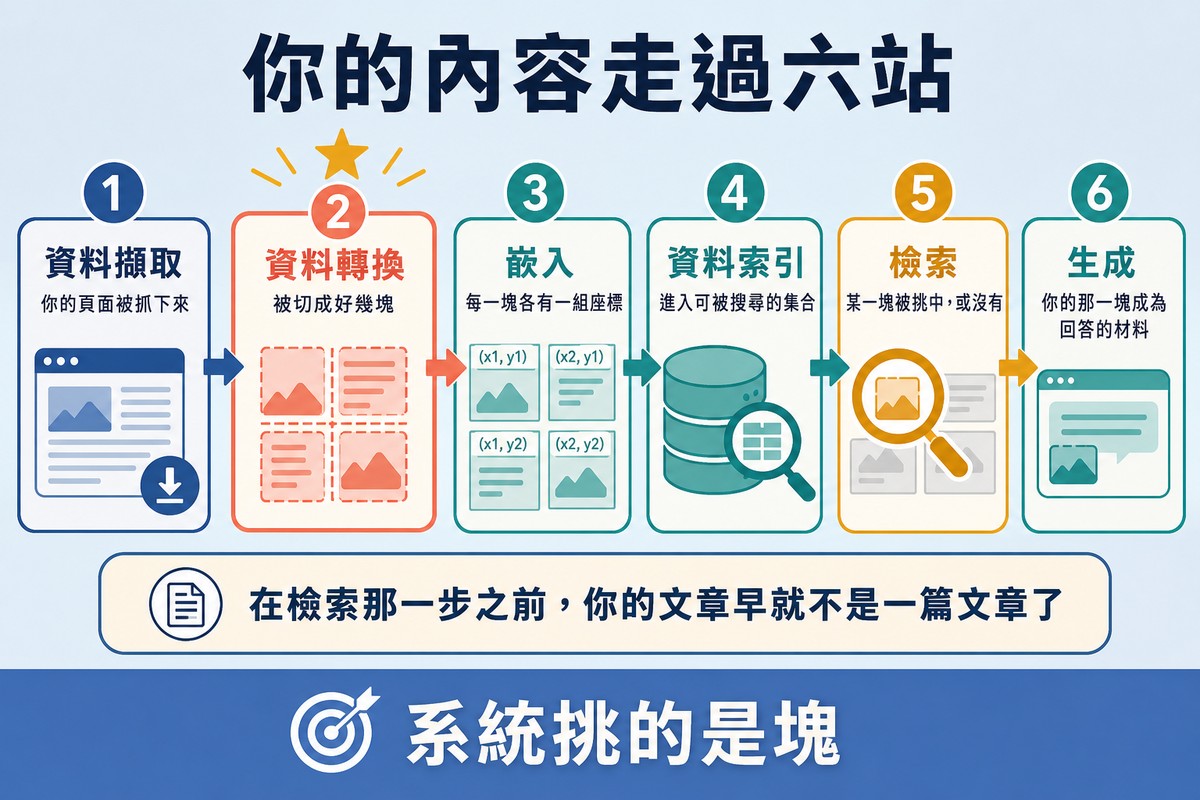
| 階段 | 官方怎麼說 | 你的內容在這一步發生什麼 |
|---|---|---|
| 資料擷取 | 從各種來源擷取資料 | 你的頁面被抓下來 |
| 資料轉換 | 「資料會分割成多個區塊」 | 被切成好幾塊 |
| 嵌入 | 「這些數字會擷取文字的語意和情境」 | 每一塊各有一組座標 |
| 資料索引 | 「索引會建構知識庫,以便進行最佳化搜尋」 | 進入可被搜尋的集合 |
| 檢索 | 「搜尋知識庫,找出與查詢相關的資訊」 | 某一塊被挑中(或沒有) |
| 生成 | 「將擷取的資訊做為脈絡,加入原始使用者查詢」 | 你的那一塊成為回答的材料 |
看完這條鏈,有一件事會變得很清楚:在「檢索」那一步之前,你的文章早就不是一篇文章了。
⚠️ 它是一堆各自獨立的塊。而系統挑的是塊,不是文章。
向量搜尋算的是相似度,不是正確性
還有一個很容易被忽略的限制:向量搜尋算的是相似度,不是正確性。
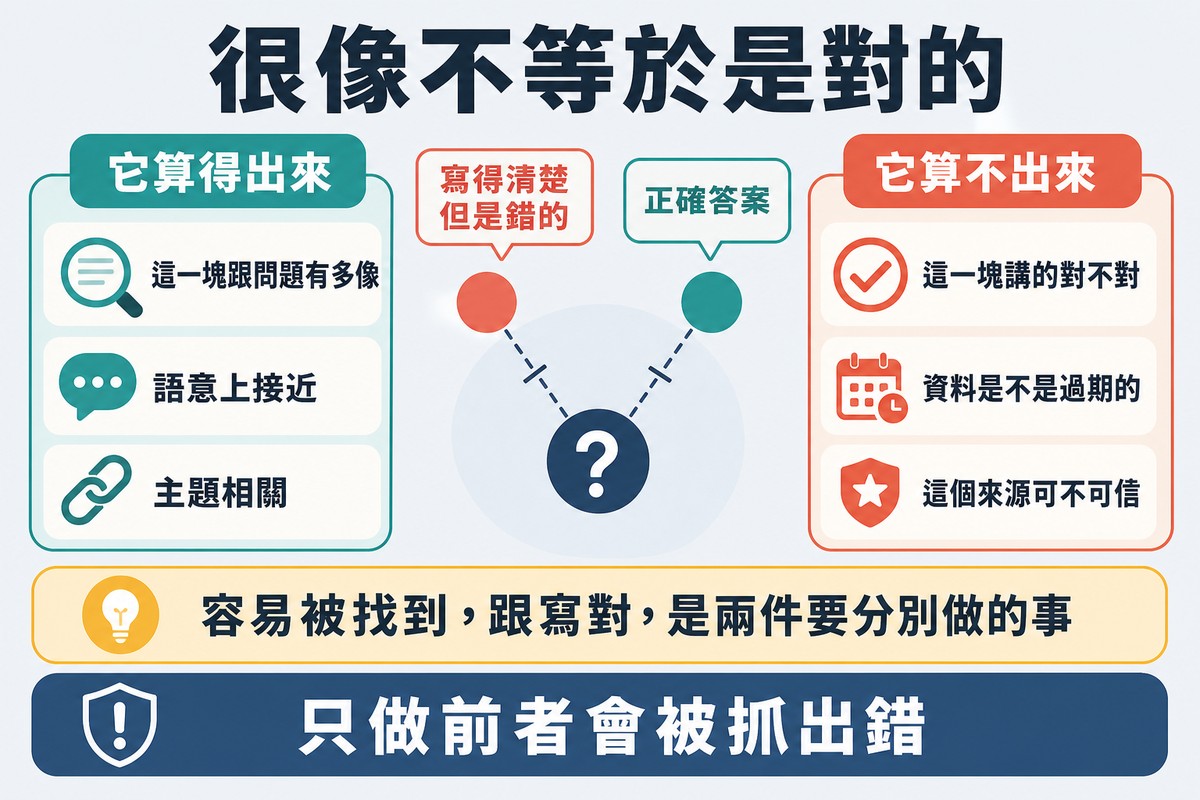
| 它算得出來 | 它算不出來 |
|---|---|
| 這一塊跟問題有多像 | 這一塊講的對不對 |
| 語意上接近 | 資料是不是過期的 |
| 主題相關 | 這個來源可不可信 |
⚠️ 注意
一段寫得很清楚、但內容是錯的文字,在座標上跟正確答案一樣近。
⚠️ 所以「被檢索到」跟「被當成答案」之間,系統還有別的判斷在做(來源品質、時效、一致性等等),而那些判斷不在向量這一層。
這對內容的意義是:把一段話寫得容易被找到,跟把它寫對,是兩件要分別做的事。⚠️ 只做前者的結果,是你很容易被找出來、然後被比對出錯誤。
向量搜尋對寫內容的人意味著什麼
不是要你把文章改寫成條列,而是三個很具體的判斷:
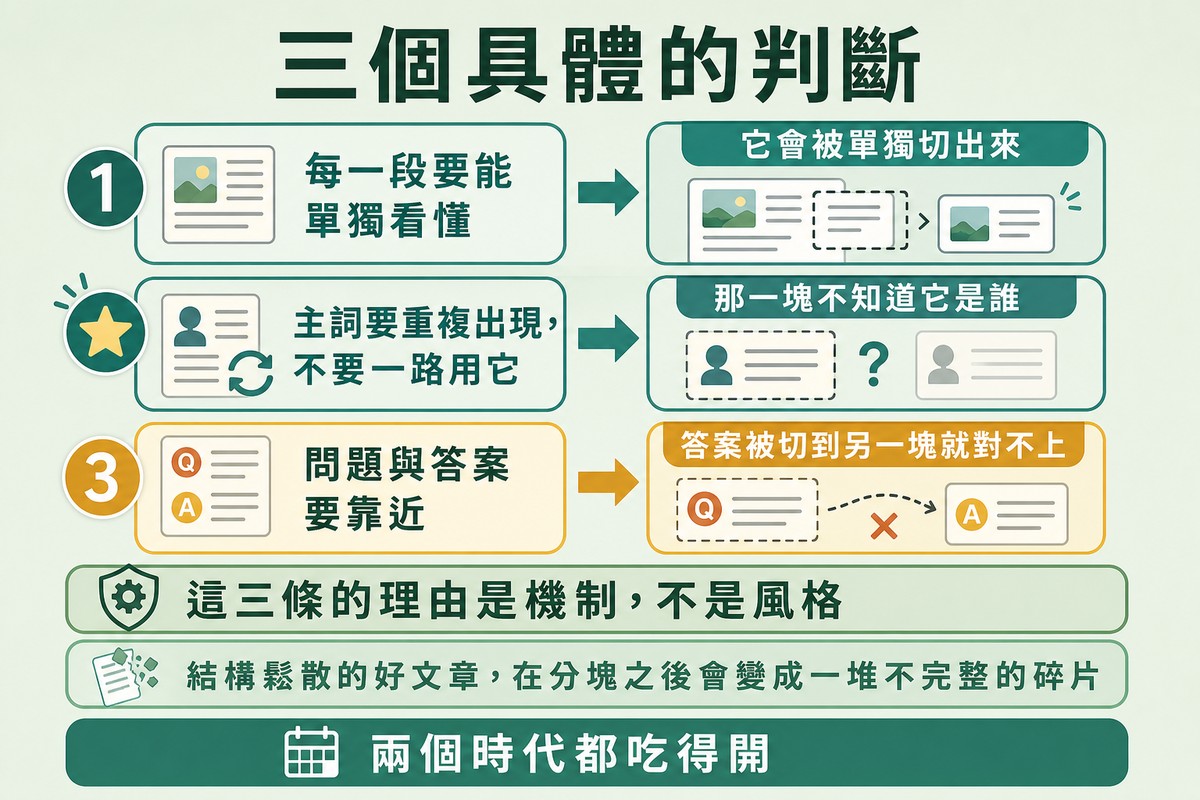
| 判斷 | 理由 |
|---|---|
| 每一段要能單獨看懂 | 它會被單獨切出來 |
| 主詞要重複出現,不要一路用「它」 | 那一塊不知道「它」是誰 |
| 問題與答案要靠近 | 答案被切到另一塊,就對不上那個問題 |
⚠️ 注意
這三條看起來像寫作建議,但它們的理由是機制,不是風格。
⚠️ 一篇結構鬆散的好文章,在關鍵字時代可能還排得不錯(因為關鍵字散在全文都算數);在分塊之後,它會變成一堆各自不完整的碎片。
反過來,一篇每段都能獨立成立的文章,在兩個時代都吃得開。 至於提高被引用機會的實際做法,站上另有一篇專門談。
自己測文章禁不禁得起被切塊的小測試
不用工具、也不用寫程式,十分鐘就能知道自己的文章禁不禁得起被切開。
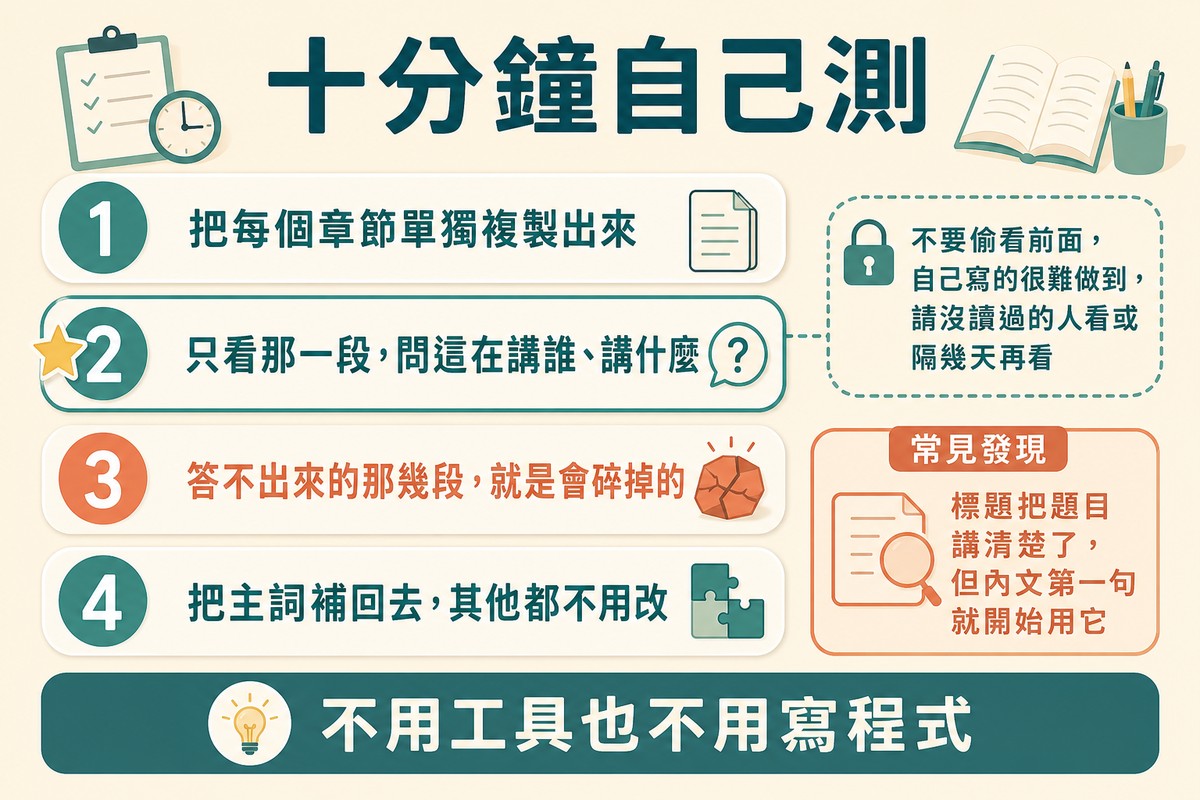
| 步驟 | 怎麼做 |
|---|---|
| 1 | 把文章的每個 H2 章節單獨複製出來 |
| 2 | 只看那一段,問自己:這在講誰、講什麼 |
| 3 | 答不出來的那幾段,就是會碎掉的那幾段 |
| 4 | 把主詞補回去,其他都不用改 |
💡 小提醒
這個測試的重點是「只看那一段」,不要偷看前面。
⚠️ 自己寫的東西很難做到這件事,因為你腦子裡有全文。比較有效的做法是請一個沒讀過這篇的人看那一段,或隔幾天再回來看。
通常會發現同一種病:章節標題把題目講清楚了,但內文第一句就開始用「它」——標題不一定會跟著那一塊走,所以那一塊就變成無主詞的內容。
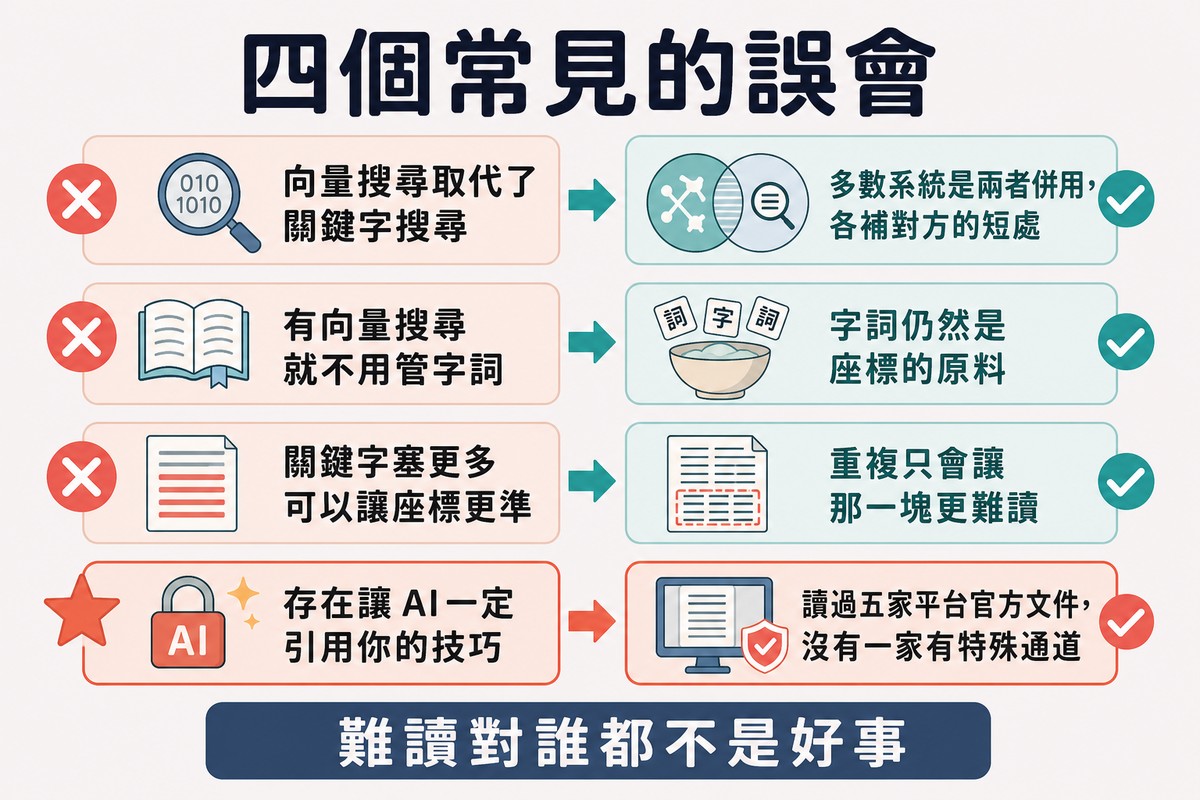
關於向量搜尋的幾個常見誤會
| 誤會 | 實際上 |
|---|---|
| 向量搜尋取代了關鍵字搜尋 | 多數系統是兩者併用,各補對方的短處 |
| 有向量搜尋就不用管字詞 | 字詞仍然是座標的原料 |
| 把關鍵字塞更多可以讓座標更準 | 重複不會讓語意更清楚,只會讓那一塊更難讀 |
| 存在某種讓 AI 一定引用你的技巧 | 站上另一篇讀過五家平台的官方文件,沒有一家有特殊通道 |
向量搜尋跟搜尋引擎有什麼關係
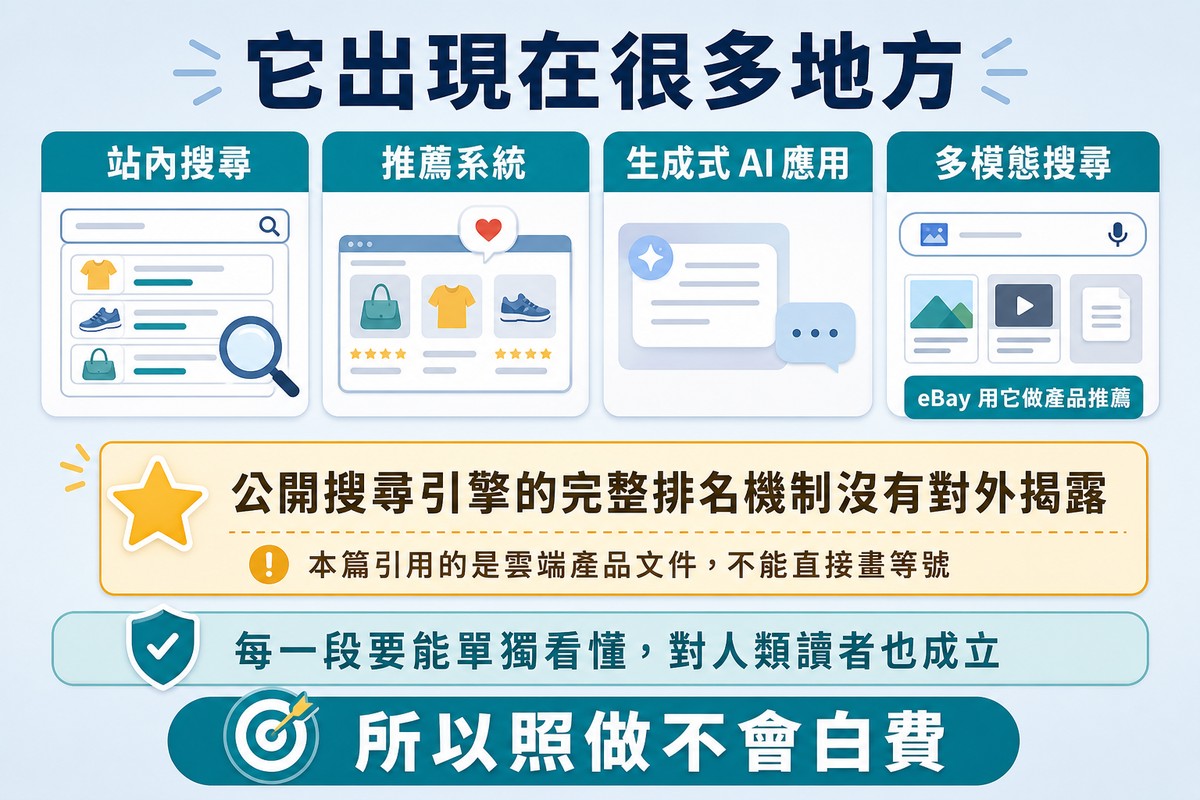
向量搜尋是一種技術,它出現在很多地方:站內搜尋、推薦系統、RAG 應用,也在各種 AI 回答的背後。
Google Cloud 官方列的應用場景就包含搜尋、推薦系統、生成式 AI 應用和多模態搜尋,客戶案例裡有 eBay 用它做產品推薦。
💡 小提醒
⚠️ 但要誠實講一件事:公開搜尋引擎的完整排名機制沒有對外揭露。
我們知道語意理解是其中一環,但沒有人能從外部確認「Google 搜尋的某一步就是這樣做的」。本篇引用的是 Google Cloud 對自家向量搜尋產品的說明,那是可以查證的;把它直接等同於公開搜尋的運作方式,那一步我不會跨。
不過有一件事不受這個限制:「每一段要能單獨看懂」這個原則,對人類讀者也成立——所以就算機制猜錯了,這件事也不會做白工。
最後講一個我實際遇到的狀況。
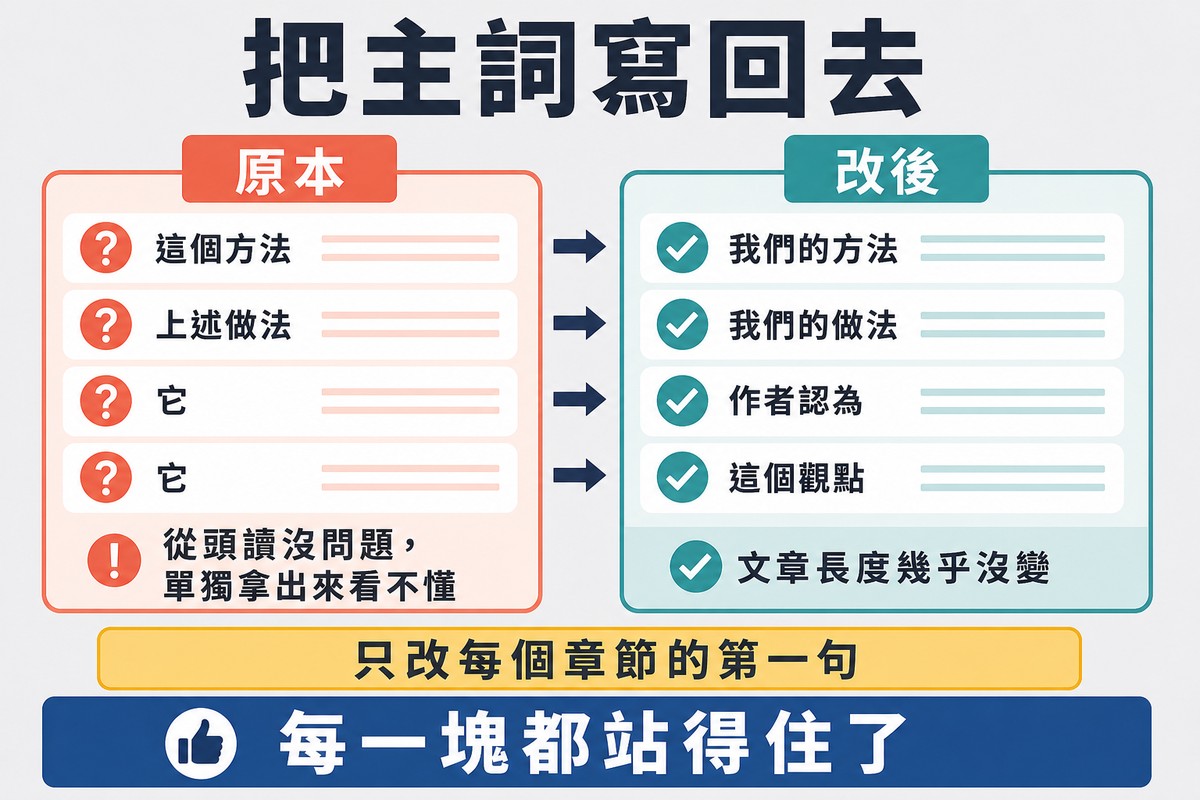
有個客戶的文章寫得很好,但整篇是用「這個方法」「上述做法」串起來的,通篇沒有再出現過主詞。
人從頭讀下來完全沒問題。⚠️ 但把它任何一段單獨拿出來,你都不知道它在講什麼。
後來只做了一件事:把每個章節的第一句改成完整的句子,主詞寫出來。 文章長度幾乎沒變,但每一塊都站得住了。
常見問題
參考資料
- Google Cloud —《Vector Search 總覽》(繁體中文,美國,雲端服務官方技術文件)
- Google Cloud —《RAG Engine 總覽》(繁體中文,美國,雲端服務官方技術文件)
ℹ️ 關於本文
本文引用的定義與流程說明,以查閱當日(2026 年 9 月 13 日)Google Cloud 官方技術文件的公開版本為準,雲端服務的文件與產品名稱會更新,實際請以官方當期版本為準。⚠️ 要特別說明的是,本文引用的是 Google Cloud 對自家向量搜尋產品的說明,不等同於 Google 公開搜尋引擎的排名機制——後者並未完整對外揭露,本文不做這樣的推論。文中刻意不提供「分塊要切幾個字」「向量維度多少比較好」「哪種相似度演算法比較準」這類數字或結論——官方文件沒有給通用建議值,網路上流傳的參數來自各家實作,不宜當成通則。本文亦不推薦任何特定的向量資料庫或雲端服務。
陳俊鳴
網路流量操盤手.企業行銷顧問
操盤SEO與網路行銷實戰逾15年,2014年創辦晨星事業有限公司(晨星行銷),從SEO網站架設、關鍵字策略到銷售漏斗與變現模式一手包辦。現為智信科技、瞻新資訊等多家企業的常年行銷顧問,也獲頒過亞洲十大卓越名師金像獎,把每一次流量成長都當成自己的事業在打。曾是馬來西亞象棋、圍棋國手,拿過亞洲盃第二名。